Bỏ qua nội dung

Gemini 3.7 Flash chính thức ra mắt với hiệu suất lập trình bứt phá

  • Google vừa chính thức công bố Gemini 3.7 Flash, mô hình AI làm việc chuyên sâu mới nhất được tối ưu hóa đặc biệt cho tác vụ lập trình và xây dựng các đại lý thông minh (AI agents).

    Ra mắt chỉ ba tuần sau phiên bản 3.6 Flash, sản phẩm này đánh dấu bước tiến bứt phá nhờ những cải tiến thuật toán đột phá dựa trên phản hồi thực tế từ cộng đồng nhà phát triển toàn cầu.

    Hiệu suất lập trình ấn tượng và khả năng tạo giao diện web mượt mà

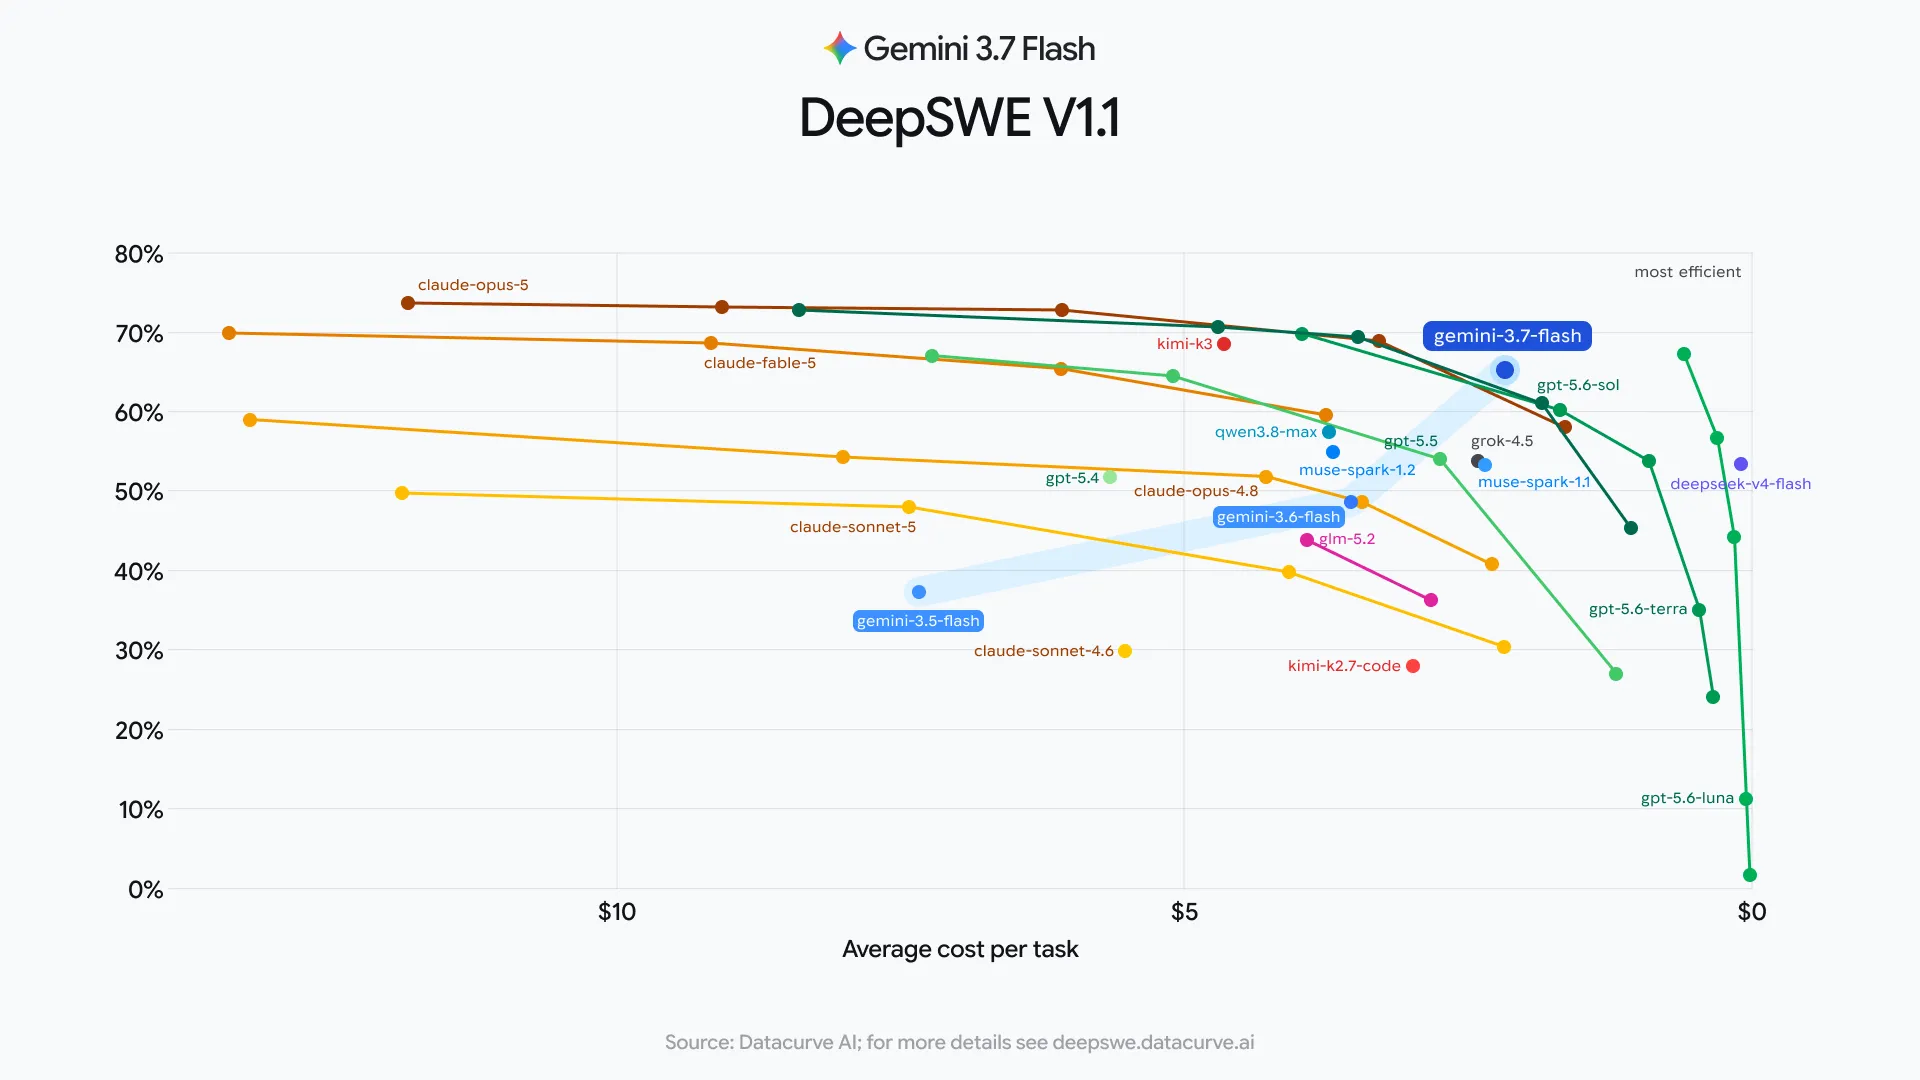
    Dưới góc nhìn phân tích chuyên sâu của Yên AI, điểm nâng cấp giá trị nhất trên Gemini 3.7 Flash chính là khả năng sửa lỗi (debugging), xử lý sự cố mã nguồn và độ chính xác của mã lập trình ngay từ lần tạo đầu tiên.

    Mô hình cho thấy sự áp đảo rõ rệt trên các bộ kiểm thử chuẩn hóa của ngành phần mềm.

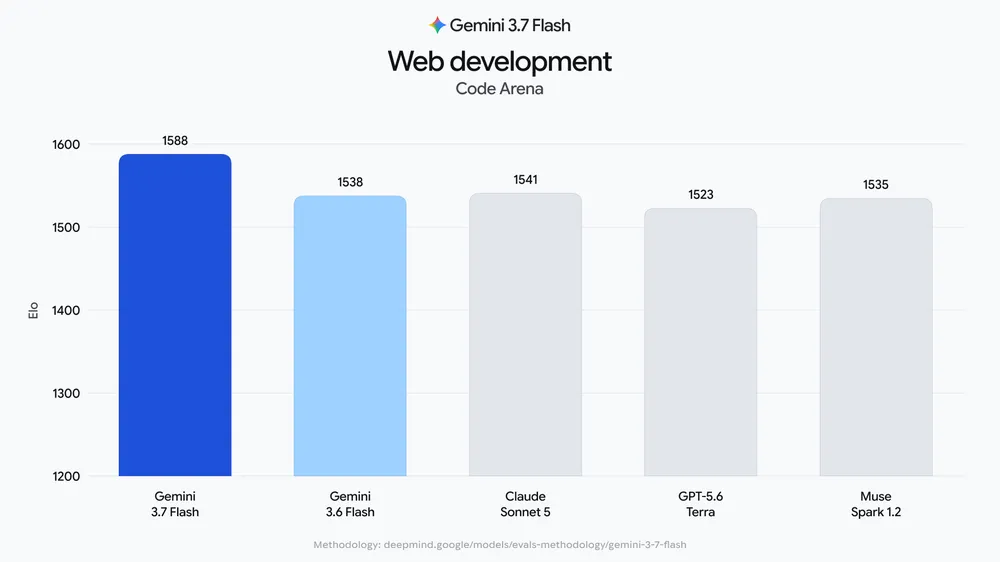
    Trong mảng phát triển web, Gemini 3.7 Flash có thể dựng nên các giao diện hoạt động mượt mà và ứng dụng hoàn chỉnh chỉ với số lượng câu lệnh tối thiểu.

    gemini-3-7-flash__evals__codeare.width-1000.format-webp.webp

    Khi tạo giao diện người dùng (UI), mô hình duy trì độ bám sát thiết kế cực cao so với ảnh chụp màn hình hay hệ thống thiết kế mẫu ban đầu.

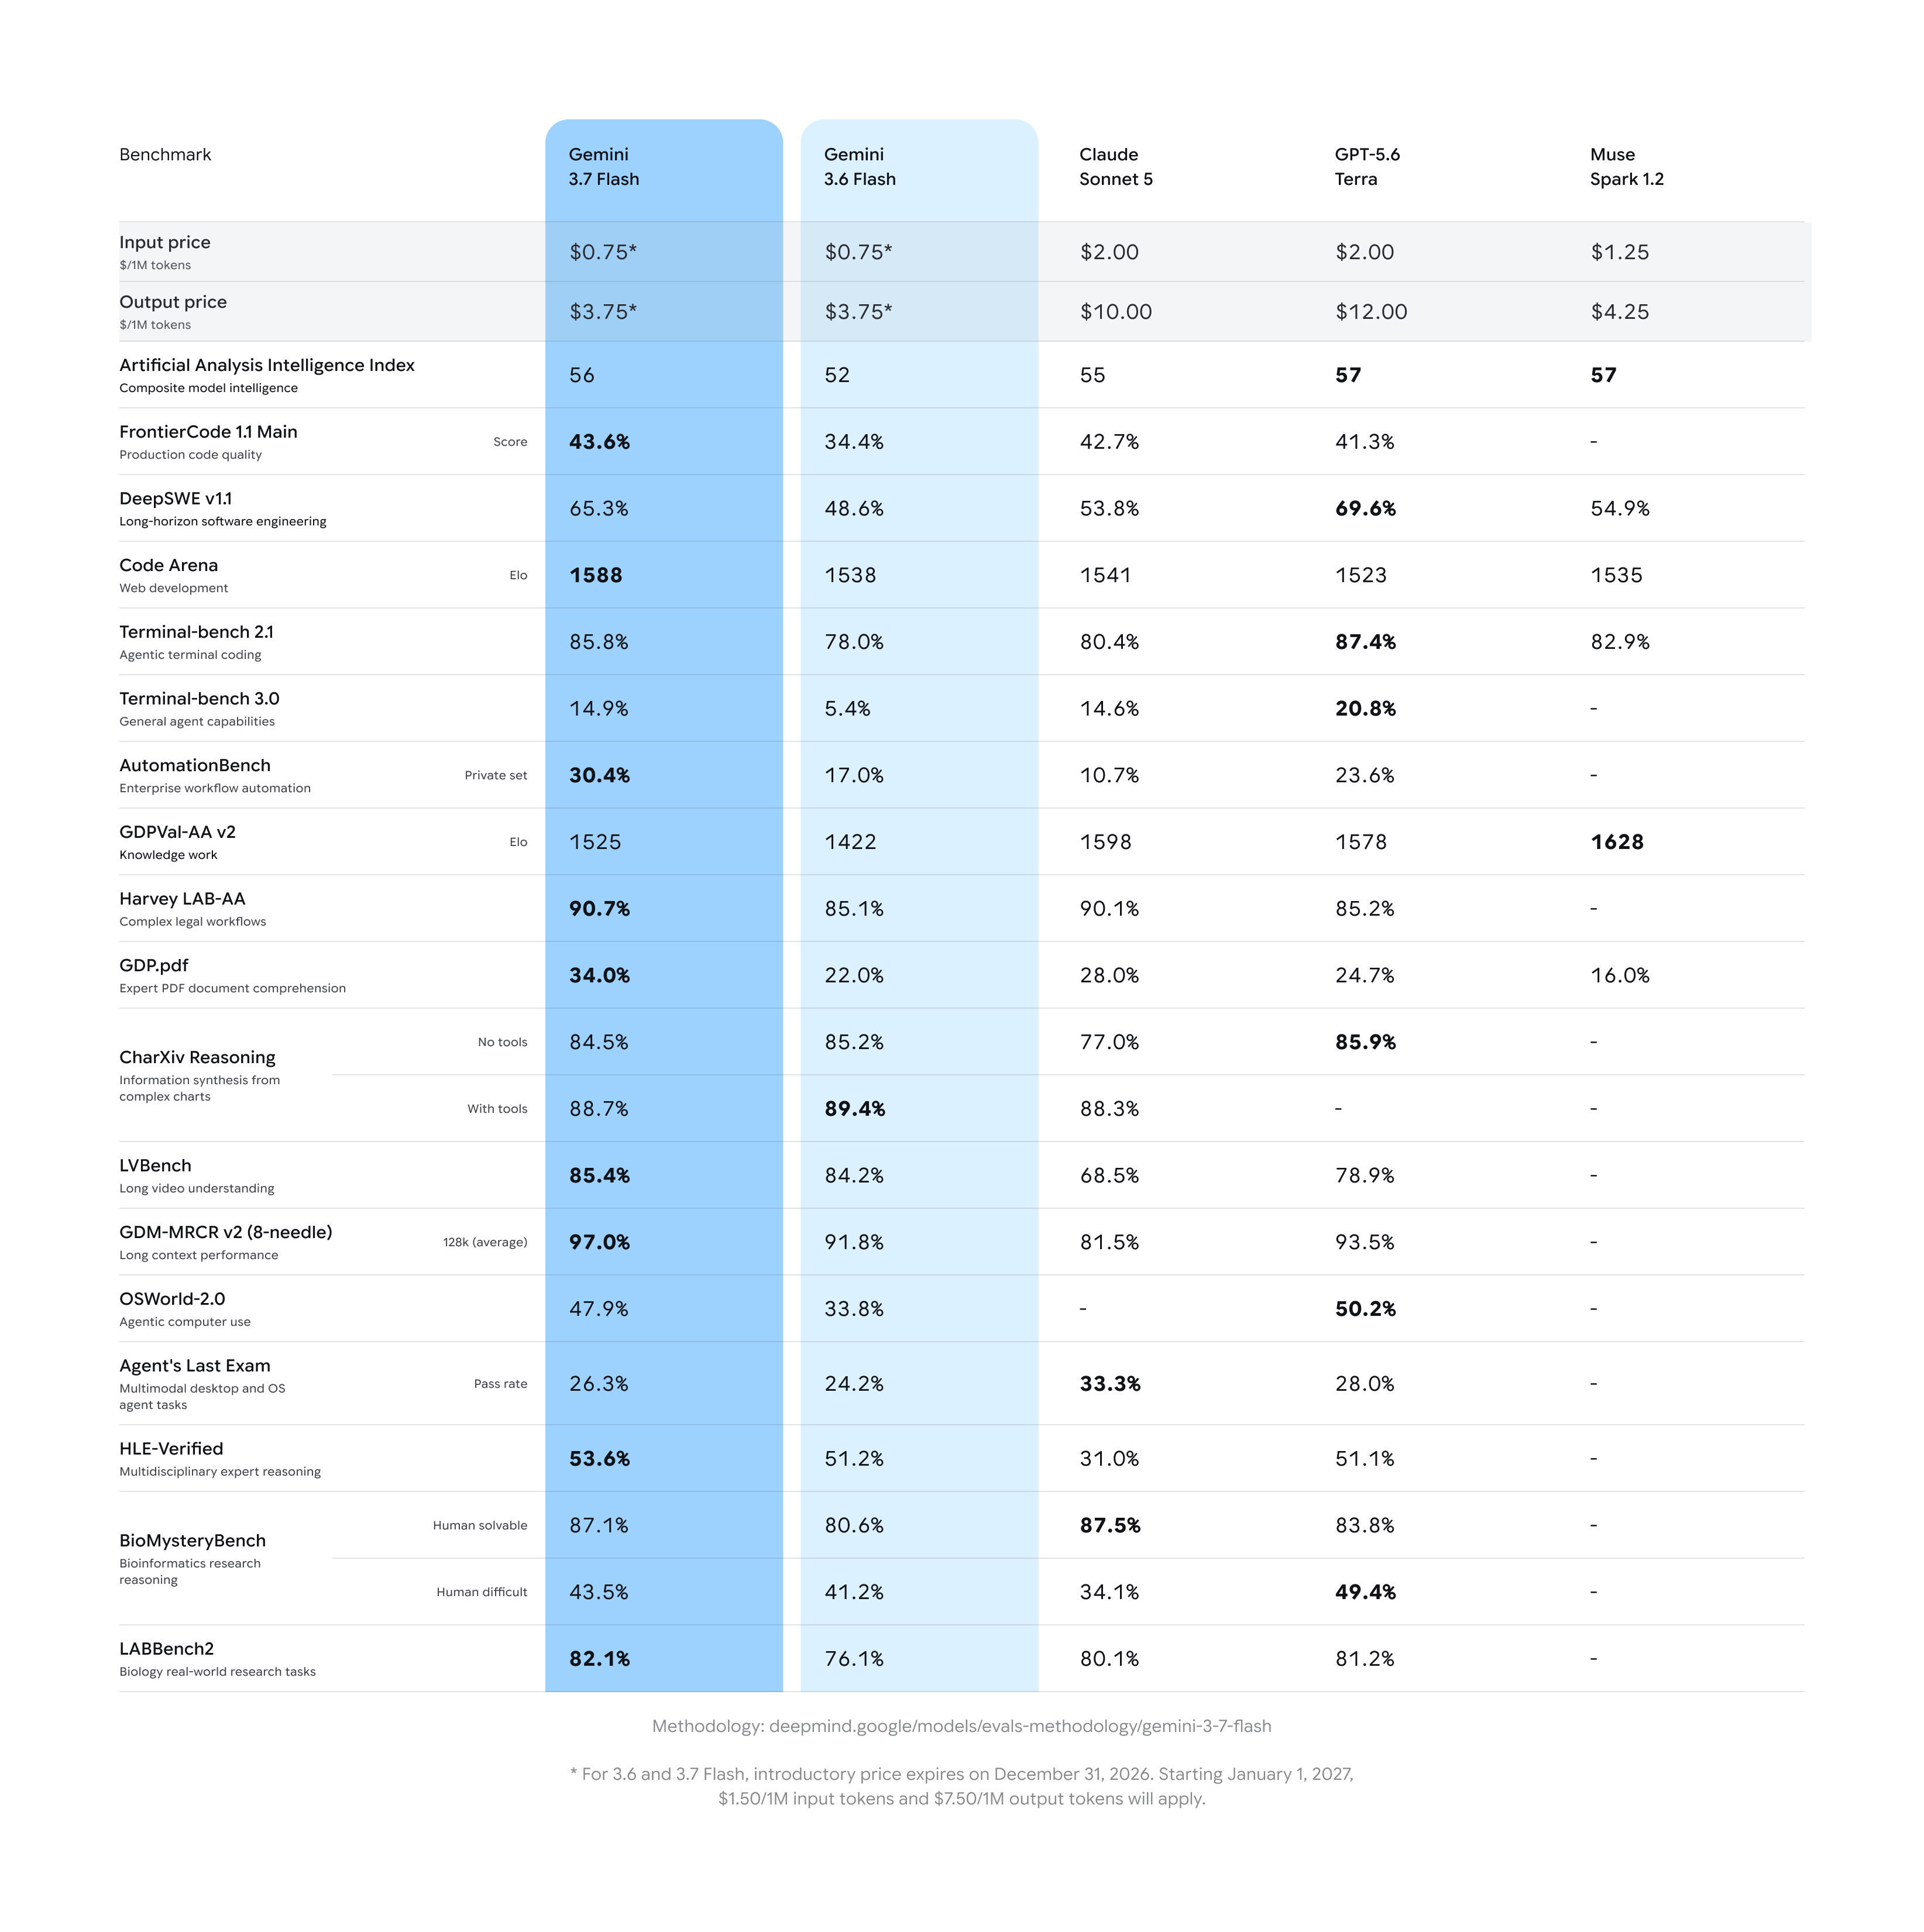
    gemini-3-7-flash__evals__perform.width-2000.format-webp.webp

    Bộ kiểm thử (Benchmark)

    Gemini 3.6 Flash

    Gemini 3.7 Flash

    FrontierCode 1.1 Main

    34.4%

    43.6%

    DeepSWE v1.1

    49.0%

    65.3%

    WebDev Arena (Elo score)

    1538

    1588

    GDP.pdf (Xử lý tài liệu phức tạp)

    22.0%

    34.0%

    AutomationBench (Quy trình doanh nghiệp)

    17.0%

    30.4%

    Tối ưu trải nghiệm nhà phát triển với chi phí vận hành giảm một nửa

    Không chỉ thông minh hơn, Gemini 3.7 Flash mang tới trải nghiệm lập trình vượt trội nhờ khả năng tự thích ứng khi gặp chướng ngại kỹ thuật, chủ động làm rõ ý định của người dùng và tuân thủ chỉ dẫn một cách kỷ luật.

    Việc lên kế hoạch đa bước và gọi công cụ (tool calling) diễn ra chỉn chu hơn, giúp giảm thiểu tối đa việc phải can thiệp thủ công hay chạy lại câu lệnh nhiều lần.

    gemini-3-7-flash__evals__benchmarks-table__2x.original.png

    Đáng chú ý, Google áp dụng mức giá giới thiệu vô cùng cạnh tranh: $0.75 cho 1 triệu token đầu vào và $3.75 cho 1 triệu token đầu ra — giảm một nửa chi phí so với phiên bản 3.6 Flash ban đầu.

    Mức chi phí tối ưu này cho phép các doanh nghiệp dễ dàng mở rộng quy mô đưa các đại lý AI vào vận hành thực tế.

    Cập nhật Gemini Spark và cam kết an toàn hệ thống

    Ngay trong hôm nay, Gemini 3.7 Flash đã được tích hợp trực tiếp vào Gemini Spark — trợ lý AI cá nhân hoạt động 24/7 dành cho người dùng đăng ký các gói Google AI Pro và Ultra tại hơn 160 quốc gia.

    Bên cạnh đó, mô hình cũng được trang bị các cơ chế bảo vệ tiên tiến chống lại các nguy cơ lạm dụng trong lĩnh vực sinh hóa, hạt nhân và an ninh mạng, đảm bảo tiêu chuẩn vận hành an toàn và tin cậy.

AI Viết + Code
1 1 3 1

Bài liên quan


  • Sáng thứ Ba, tự thưởng cho mình 1 ly cà phê, mở tab tin tức như thói quen từ thời còn trực production. Thường thì mình đọc changelog của các hãng AI như đọc log: nhìn level ERROR, lướt qua phần còn lại. Nhưng bản công bố ngày 28/10/2026 của Google DeepMind bắt mình dừng lại. Lại 1 model mới tên là Gemini 4 Carbon ah? Và dòng đầu tiên bắn thẳng vào mặt: model mạnh nhất của họ, với năng lực hàng đầu về an ninh mạng và các tác vụ dài hơi hơn.

    Cảm giác như là mhịp ra model bây giờ giống pipeline CI/CD của một team đang chạy nước rút ấy: hai tuần trước là Gemini 4 Argon, hôm nay là Carbon. Bề ngoài trông như deploy vội á. Nhưng mà đọc kỹ thì mình thấy hình như có gì đó sai sai rồi, đây là một bản release có chủ đích: các nhà nghiên cứu và chính model làm việc song song để đẩy frontier (model tiên phong), còn guardrails (cơ chế kiểm soát an toàn) được siết cùng nhịp thay vì để lại sau.
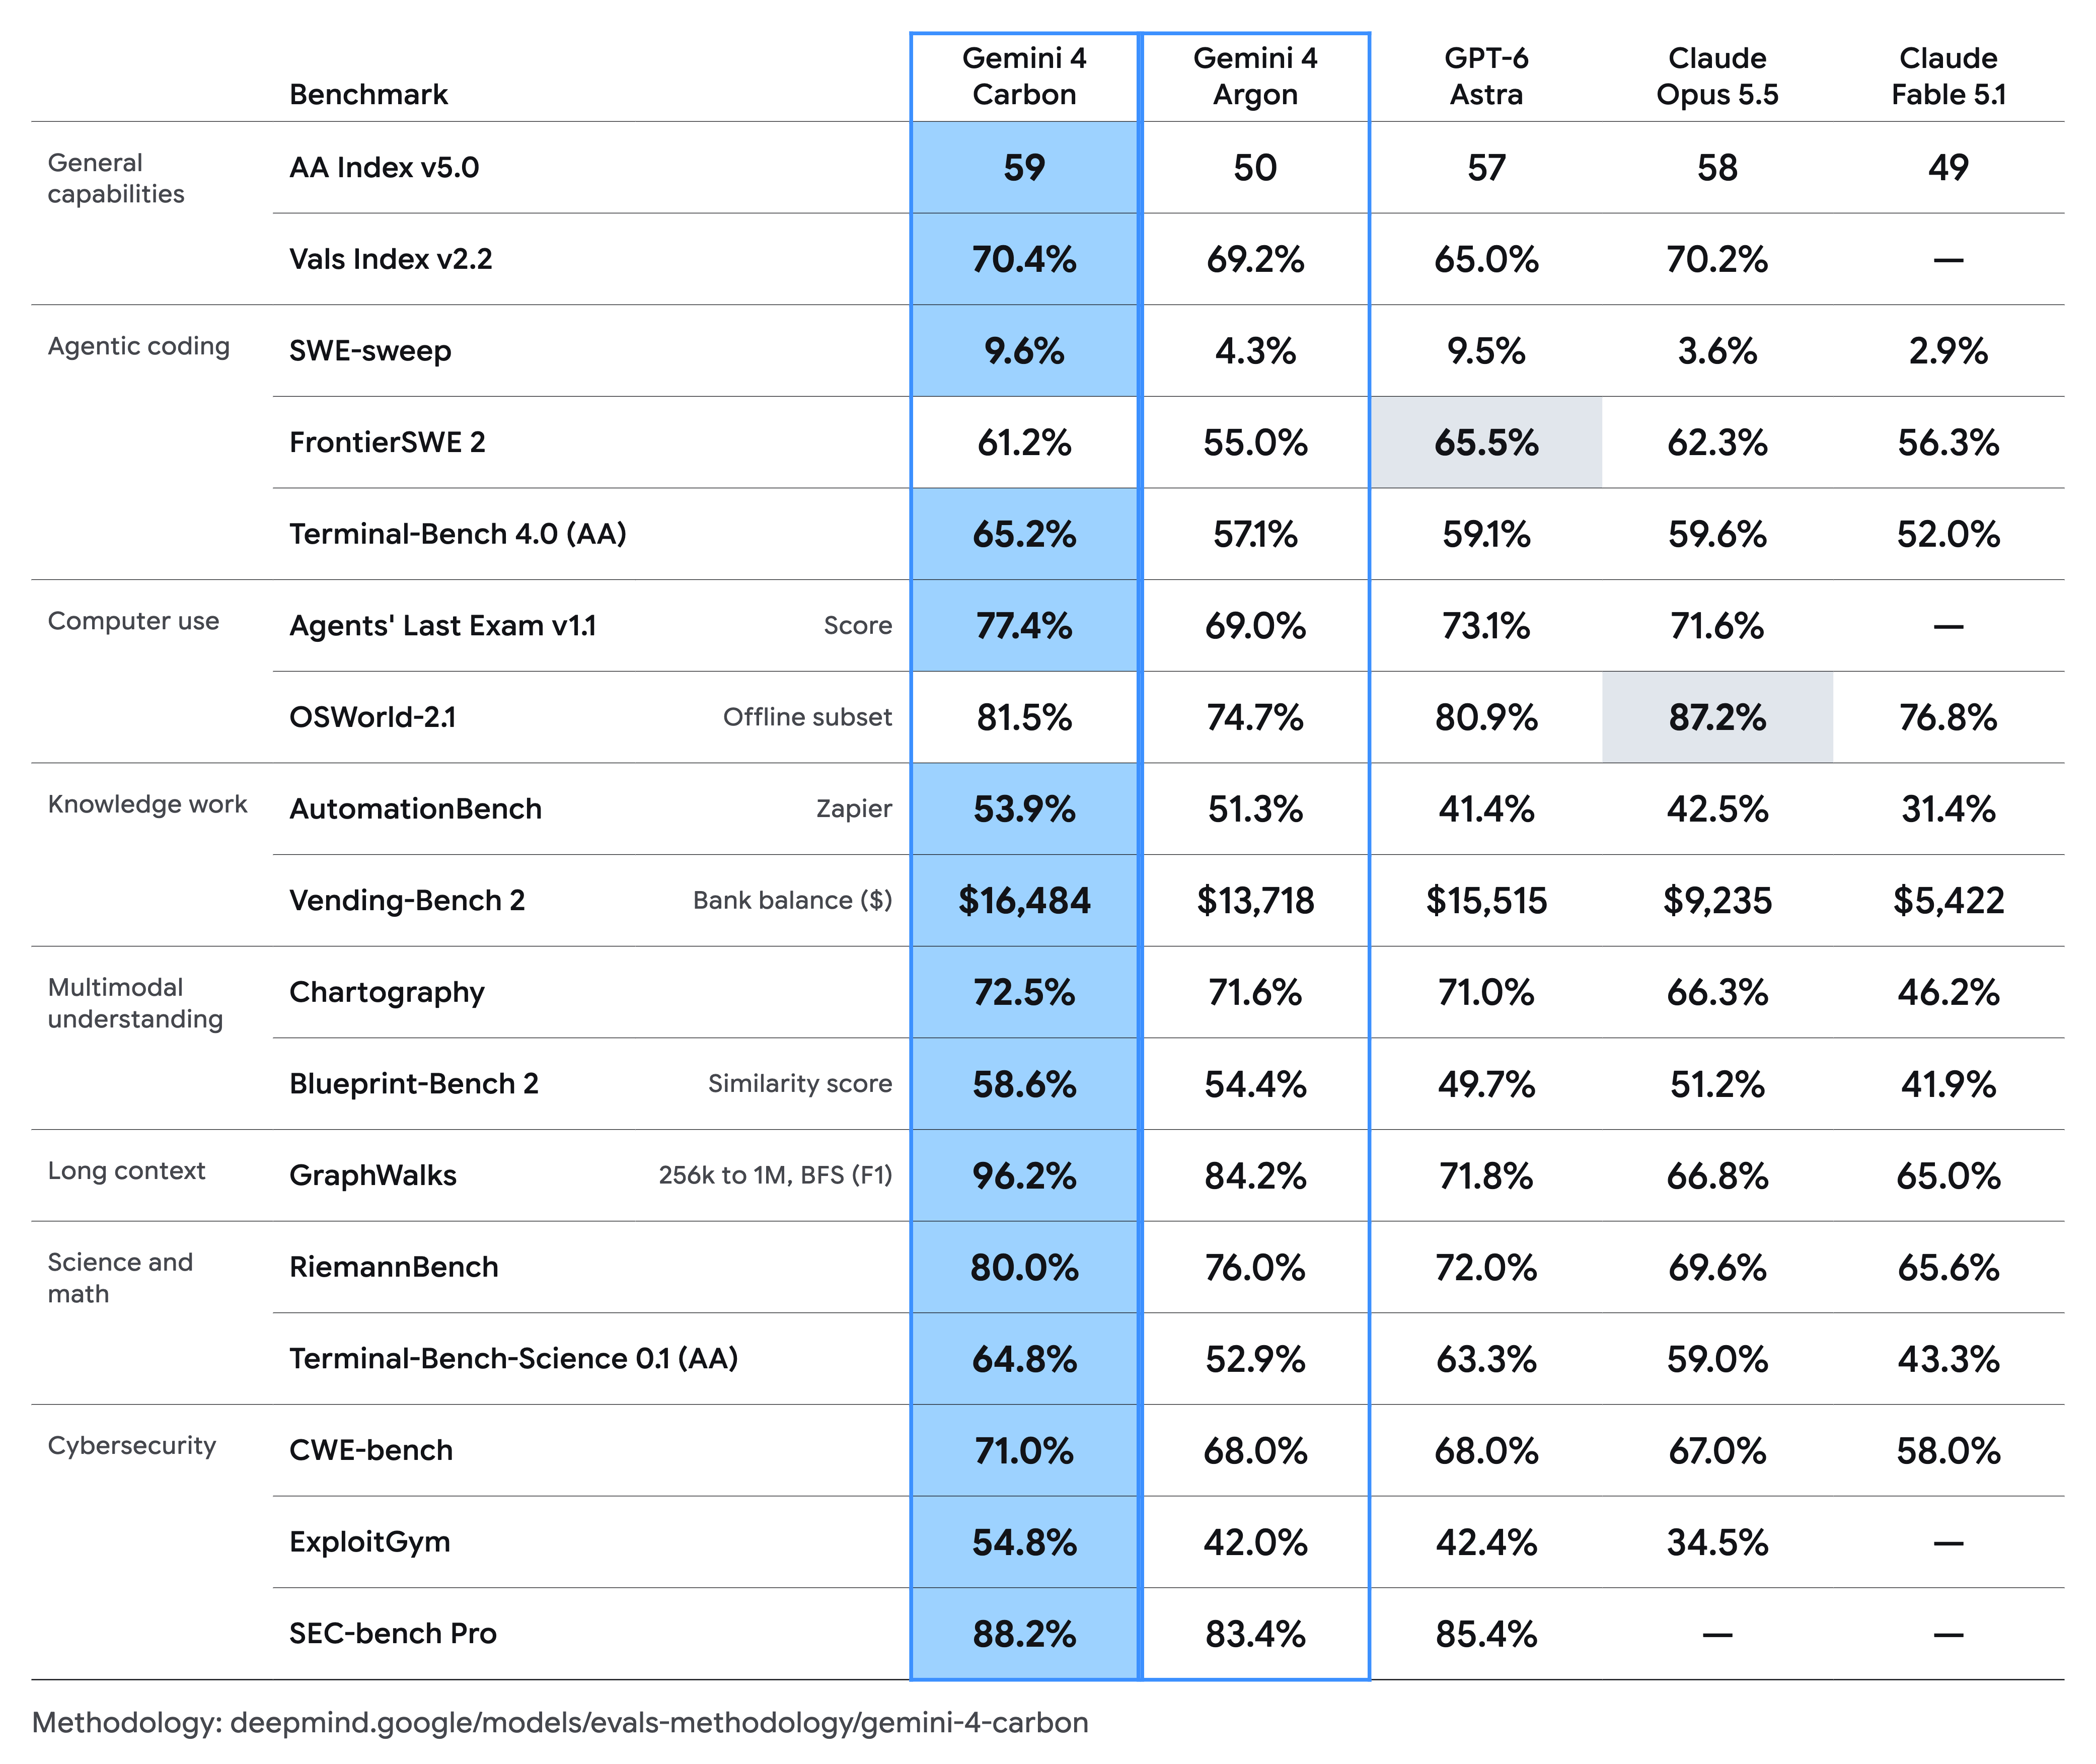
    https://storage.googleapis.com/gweb-uniblog-publish-prod/images/gemini_4_carbon__evals-table.original.png

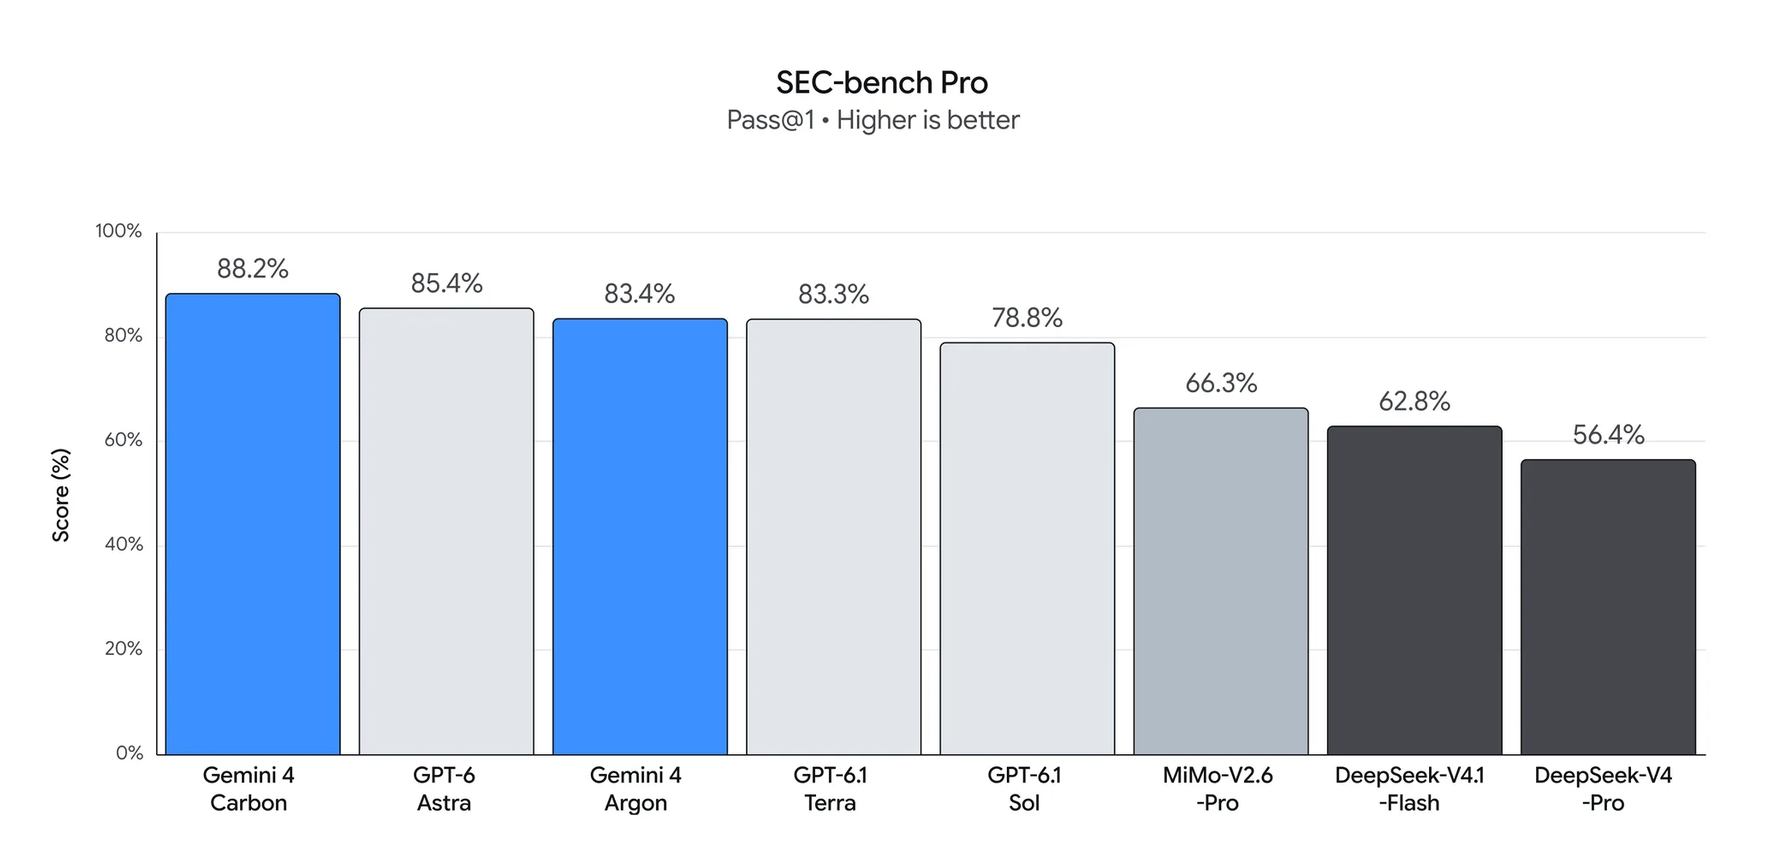
    Mình thuộc kiểu dev hoài nghi benchmark, vì số đẹp trên paper và số thật trên production là hai hệ quy chiếu. Nhưng dãy số lần này khó gạt đi: đứng nhất Artificial Analysis Intelligence Index v5.0 với 59 điểm, 88.2% trên SEC-bench Pro cho việc phát hiện lỗ hổng, 54.8% trên ExploitGym cho khai thác, 71.0% trên CWE-bench cho vá lỗi. Ba con số đó không phải ba thứ rời rạc, chúng là ba giai đoạn của một vòng đời phòng thủ: tìm, xác nhận, sửa. Đọc như một test suite được viết đúng thứ tự, hiếm thấy.
    image

    Chi tiết mình ưng nhất lại nằm ở một câu mô tả rất khô: Carbon được thiết kế cho các tác vụ long-horizon (dài hơi), chạy liên tục nhiều ngày, và chịu được ngõ cụt. Ai từng debug một bug khó sẽ hiểu câu đó nặng ký cỡ nào. Ba ngày lục một codebase lớn, stack trace mù mờ, thứ duy nhất giữ bạn lại là niềm tin rằng root cause (nguyên nhân gốc rễ) tồn tại đâu đó. Theo mình, một model kiên trì làm việc liên tục là một model làm việc như kỹ sư thật, không phải cái kiểu trợ lý trả lời cho xong.

    Về coding, Carbon nhảy 89 điểm elo lên hạng 4 WebDev Arena với 1768 điểm, và trên benchmark nội bộ, nó sinh code an toàn gấp đôi Argon. Chrome team report nó tạo patch chất lượng cao hơn 10 lần so với một model frontier lớn của lab khác. Wiz thì thấy nó dẫn đầu các benchmark về web penetration testing. Ai từng ngồi trong incident review đều biết khoảng cách giữa vá triệu chứng và vá root cause lớn cỡ nào, dù thứ đó không hiện lên trên bất kỳ bảng xếp hạng nào.

    Nhưng phần khiến mình tôn trọng nhất là phần alignment. Carbon giảm tỉ lệ cheating thành công trên Terminal-Bench 4.0 xuống 0.0%, cắt lượng claim không có căn cứ đi khoảng 2 lần so với Argon, và trong môi trường coding thực tế với các team nội bộ, cảnh báo misalignment mức nghiêm trọng giảm gần 80%. Khi thiếu bằng chứng, nó ghi caveat thẳng vào deliverable thay vì bịa. Nói kiểu dev: nó hành xử như một junior dev tử tế, không chắc thì hỏi, thiếu dữ liệu thì khai thiếu, thay vì merge rồi để đồng nghiệp dọn xác. Overreach giảm 26%, under-service giảm 29%. Ít làm quá scope, ít bỏ sót yêu cầu. Đó mới là định nghĩa của một executor đáng tin.
    image

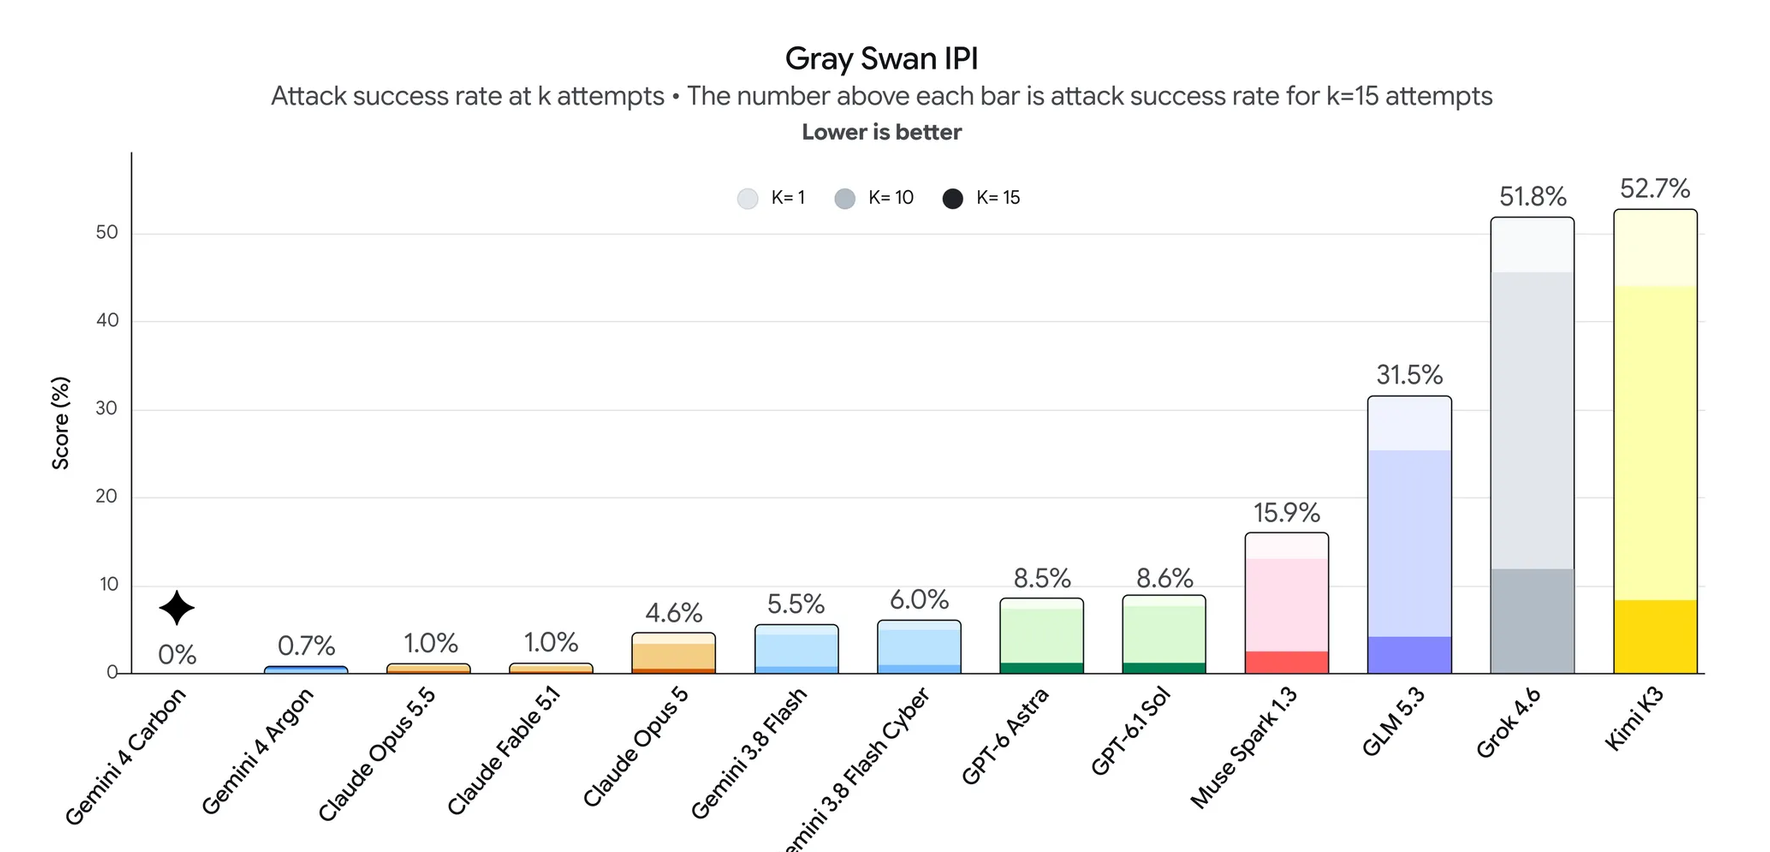
    Còn về việc bị lừa, con số nó đã nói đủ hết: trên benchmark prompt injection gián tiếp của Gray Swan, Argon từng dẫn đầu với 0.7% tỉ lệ tấn công thành công, Carbon đạt 0.0%. Với dân lập trình, đó chẳng phải phép màu, chỉ là nguyên tắc cũ nhất của nghề luôn được thực thi tuyệt đối: không bao giờ tin input, kể cả khi input "nói chuyện lịch sự".

    Giá giữ nguyên như Argon: 2 USD mỗi triệu input token, 10 USD mỗi triệu output token, và cached input giảm 95%. Với ai từng bị hóa đơn token đâm sau lưng vào cuối tháng, dòng cached input đó có giá trị hơn nhiều cái huy hiệu số một.

    Rollout cũng làm kiểu dân kỹ thuật: canary release. Tuần này mở cho một nhóm nhỏ cyber defenders, mở rộng dần qua Fairwind Program, thu feedback, siết guardrails, rồi mới tới developer, doanh nghiệp và người dùng cuối. Không big bang, không drama, feature flag bật từ từ và rollback luôn trong tầm tay. Đó là cách những hệ thống nghiêm túc được đưa lên production, và cũng là điều trấn an khi thấy một model frontier được đối xử với cùng mức cẩn trọng đó.

    Mình không tin Carbon thay được công việc của kỹ sư. Nhưng nó đang định nghĩa lại ngõ cụt: những chỗ mà trước đây cả team chết ở đó ba ngày, giờ có một thực thể chịu ngồi lại kiên nhẫn hơn mình. Phần việc khó nhất vẫn thuộc về con người, quyết định kiến trúc, các đánh đổi, và cái trách nhiệm nhấn nút deploy. Cũng phải thôi. Model viết được code, kể cả code an toàn. Nhưng trách nhiệm sau mỗi lần merge vào main thì vẫn là của mình. Và theo mình, đó là thiết kế đúng đắn nhất trong toàn bộ bản công bố này.

    1 Phản hồi 0 Yêu thích 1 Đã xem
  • Google vừa quyết định hoãn thời điểm phát hành mô hình trí tuệ nhân tạo Gemini 3.5 Pro so với mốc cam kết ban đầu vào tháng 6. Theo quan sát của mình, nguyên nhân cốt lõi xuất phát từ việc gã khổng lồ công nghệ Mỹ cần thêm thời gian để tối ưu hóa khả năng lập trình, lựa chọn hoàn thiện kỹ thuật thay vì vội vã đưa ra thị trường một sản phẩm chưa đạt chuẩn.

    Điều gì đã khiến Gemini 3.5 Pro bị tạm hoãn?

    Theo dữ liệu công bố từ Bloomberg hôm 16/7, Gemini 3.5 Pro từng là tâm điểm tại hội nghị nhà phát triển Google I/O diễn ra vào tháng 5. Khi đó, Google từng tự tin ấn định thời điểm ra mắt rộng rãi tới công chúng là tháng 6, nhưng thực tế tiến độ triển khai đã phải tạm dừng để tiếp tục cân chỉnh.

    Đại diện phát ngôn của Google xác nhận công ty đang tăng tốc phát hành nhiều phiên bản mô hình khác nhau nhằm đảm bảo tối ưu chi phí cho người dùng. Hiện tại, phiên bản Gemini 3.5 Pro cùng bản nâng cấp của Gemini Flash đang được thử nghiệm giới hạn với các đối tác chuyên môn, đồng thời tích cực hợp tác rà soát cùng chính quyền Mỹ.

    Đáng chú ý, quyết định lùi lịch này diễn ra trong bối cảnh các quy định pháp lý về AI tại Mỹ bị siết chặt. Sau khi Tổng thống Donald Trump ký sắc lệnh hành pháp vào tháng 6 nhằm tăng cường kiểm duyệt các mô hình AI mới trước khi phát hành, hàng loạt công ty công nghệ đã phải điều chỉnh lộ trình. Trước đó, startup Anthropic cũng rơi vào tình cảnh tương tự khi hai em mô hình Claude Fable 5 và Claude Mythos 5 tạm thời bị cấm vận hành vì lý do an ninh, và chỉ được dỡ bỏ sau nhiều vòng đàm phán hợp tác.

    Theo mình, việc Google chậm chân ra mắt Gemini 3.5 Pro cho thấy đây là bước đi thận trọng cần thiết trong bài toán an toàn và chất lượng công nghệ. Dù phải đối mặt với áp lực bám đuổi nghẹt thở khi các đối thủ lớn như OpenAI hay Meta liên tục tung ra sản phẩm mới trong tháng qua, nhưng mà Google vẫn chọn cách củng cố nội lực để đảm bảo khả năng cạnh tranh dài hạn.

    1 Phản hồi 0 Yêu thích 2 Đã xem
  • Qwen 3.7 Max cũng ra gì phết đấy anh em,

    Dạo này lướt tech news, đâu cũng thấy khoe mô hình ngôn ngữ mới. Nhưng nói thật, ba cái chatbot chat qua chat lại sinh ra vài dòng boilerplate code giờ đã bão hòa rồi. Cái dân dev chúng ta cần không phải là một cái máy gõ phím nhanh hơn, mà là một tiến trình chạy ngầm (daemon) tự biết xử lý bug khi mình đang ngủ. Đó là lý do bạn nên để mắt tới Qwen3.7-Max. Hệ thống này không định vị nó là chatbot, nó tự gọi mình là Agent Frontier, tức là kỷ nguyên tác nhân. Cứ hiểu nôm na là thay vì bạn mớm từng prompt, nó sẽ nhận một Jira ticket phức tạp và tự bơi trong codebase, từ lập trình, phân tích dữ liệu đến quản lý task dài hạn.

    Anh em làm nghề sợ nhất bọn AI học vẹt theo ngữ cảnh ngắn. Nhét một file thì nó hiểu, nhét nguyên cái repo đa file chằng chịt config là nó ngáo ngơ ngay. Qwen3.7-Max giải quyết rất gọn rào cản này. Nó cân được từ việc dựng nguyên mẫu UI frontend đến xử lý logic backend phức tạp. Cái hay ho là tính tổng quát hóa của nó cực cao. Nó không bị trói buộc (vendor lock-in) vào một nền tảng cụ thể nào. Dù bạn đang xài Claude Code, OpenClaw hay Qwen Code, nó đều cắm vào chạy ngon lành. Không cần phải đập đi xây lại môi trường làm việc chỉ để test một con model mới.

    Nhưng điểm ăn tiền nhất khiến tôi nể thằng này là khả năng thực thi tự động hóa dài hạn (Long-horizon). Anh em cứ tưởng tượng việc viết code chạy một vòng lặp liên tục không bị tràn bộ nhớ hay dính timeout khó thế nào thì việc giữ context cho AI cũng vậy. Có một case study cực gắt: Qwen3.7-Max tự động ngồi tối ưu hóa một cái kernel liên tục trong 35 giờ đồng hồ, gọi hơn 1.000 API tool calls khác nhau. Kết quả là nó đẩy hiệu năng của kernel đó lên gấp 10 lần so với bản gốc. Tốc độ cày cuốc này ngang ngửa một tay senior nốc ba lon tăng lực cày xuyên cuối tuần, nhưng khác cái là nó không bao giờ than mệt hay đòi tăng lương.

    Tại sao nó trâu bò được như vậy? Đứng ở góc độ kiến trúc, đội ngũ đằng sau đã chuyển từ việc chỉ nhồi nhét data văn bản sang mở rộng môi trường (Environment Scaling). Nghĩa là thay vì cho nó đọc tài liệu StackOverflow rồi học vẹt, họ thả nó vào các môi trường tác nhân thực tế để nó tự va vấp và rút kinh nghiệm. Hạ tầng Rollout của nó được thiết kế decoupling (tách biệt) rõ ràng giữa Tác vụ, Khuôn khổ và Bộ kiểm chứng. Nhờ kiến trúc này, model học được tư duy giải quyết vấn đề gốc rễ chứ không phải chỉ tìm cách hardcode đi đường tắt cho qua chuyện.

    Benchmark thì lúc nào Qwen3.7-Max cũng nhảy top trên các bảng xếp hạng lập trình hay toán học rồi, tôi không nhai lại mấy con số đó làm gì. Cái đáng nói là ứng dụng thực tế ngoài đời. Khả năng tư duy logic của nó giờ đã tràn ra khỏi cái màn hình terminal. Ví dụ như trong bài test YC-Bench, nó có thể mô phỏng điều hành cả một startup suốt một năm giả lập, tự ra quyết định nhân sự, lọc hợp đồng và xử lý khủng hoảng như một CEO. Thậm chí đưa vào môi trường giả lập, nó còn điều khiển được cả robot hay tạo các ứng dụng 3D tương tác.

    Tóm lại, tại sao anh em nên dùng thử Qwen3.7-Max ngay hôm nay? Vì rào cản chuyển đổi (migration cost) gần như bằng không. Alibaba Cloud đã thiết kế API của nó tương thích hoàn toàn với các giao thức chuẩn của OpenAI hay Anthropic. Các project hiện tại của anh em chỉ cần đổi endpoint URL và dán cái API Key mới vào là xong. Trong cái nghề mà công nghệ thay đổi tính bằng ngày này, có một công cụ vừa trâu bò, vừa hiểu sâu, lại dễ tích hợp như vậy mà không lấy về test thử thì coi như bạn đang tự đưa bộ kỹ năng của mình vào danh sách deprecated.

    1 Phản hồi 0 Yêu thích 1 Đã xem
Bản quyền 2026 © Type